从系统助手到开放工具:今天优先看实际交付与可控执行,而非排行榜口号。
核心判断:新版Siri与应用生态把AI带入真实入口;另一边,模型公司与算力供应商对发展节奏公开分歧。建设者最该做的是验证任务完成率、数据边界和授权控制。
今日信息图
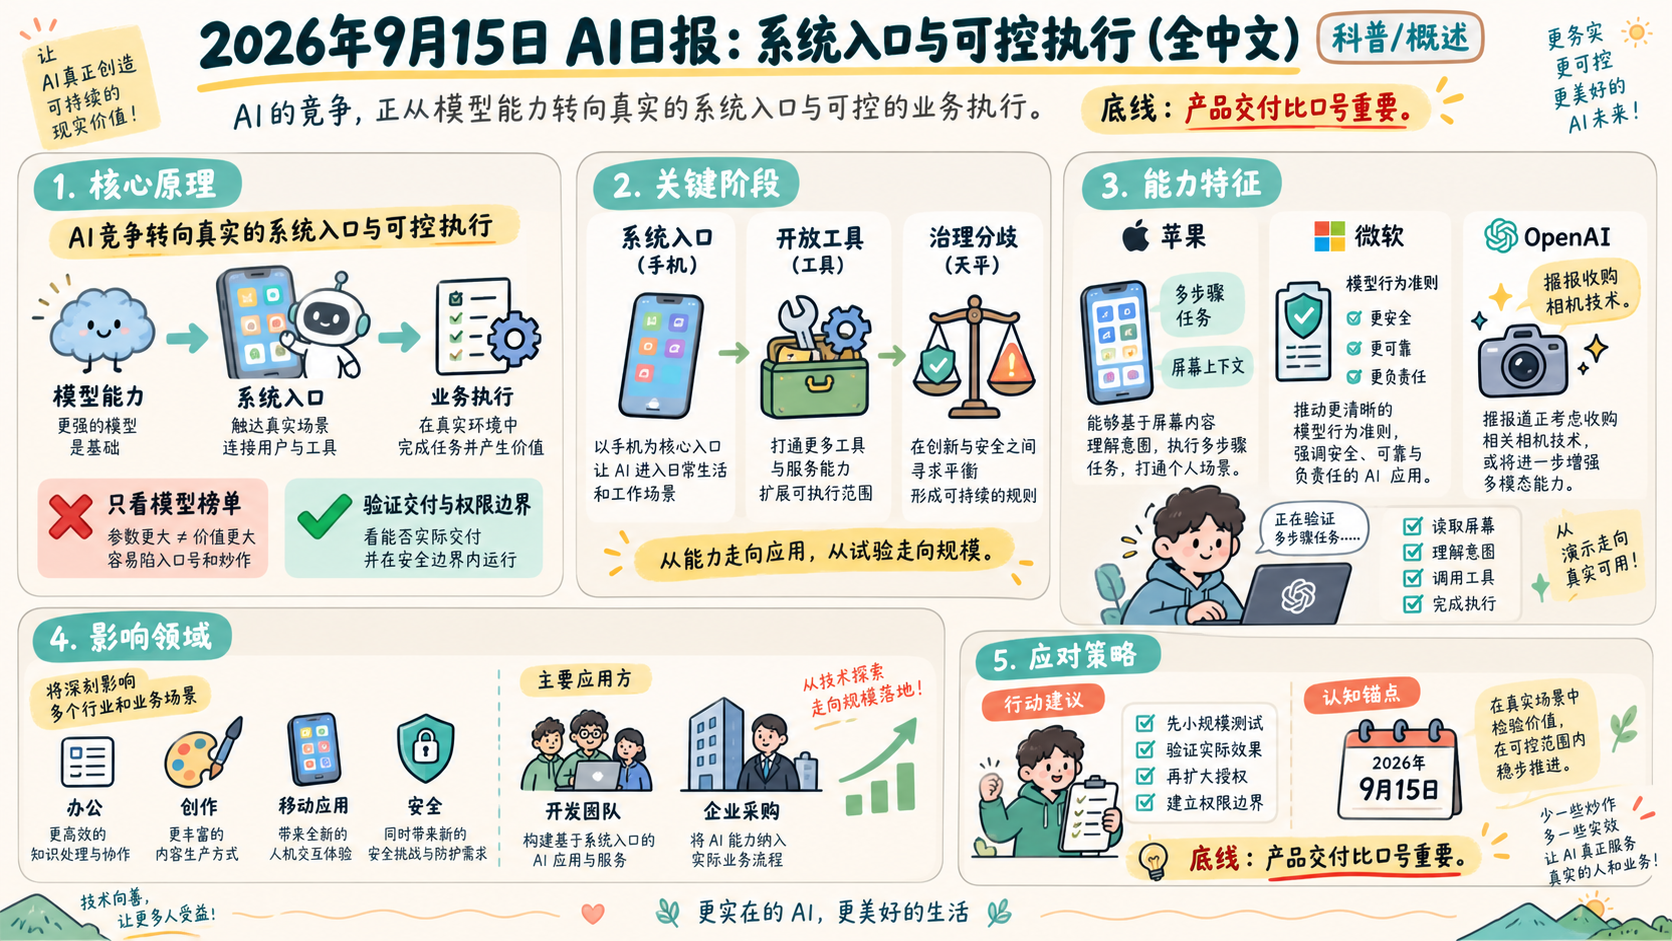
今日主线:系统入口、开放工具、治理分歧与可控执行。
今日摘要
今天的产品主线是分发:Siri依托操作系统上下文执行任务,Daydream把视觉识别接入购物,ElevenLabs把音乐能力提供给应用和API使用者。开放搜索智能体则把竞争扩展到训练方案与可复现流程。它们共同说明:模型能力只有进入具体工作流,才有机会转化为业务价值。
治理主线出现明显分歧:微软强调人类控制,OpenAI讨论训练前检查,NVIDIA反对放缓。与此同时,人工评审对话和深度伪造执法提醒企业,数据访问、用户同意和事故处理并非上线后的补丁。以下区分产品交付、媒体报道、有限测试和趋势分析,不把旧闻刷新当作新模型发布。
关键判断
Top 20 新闻
发生了什么:TechCrunch在9月14日的体验报道中确认,新版Siri随iOS 27交付,基于Gemini支持复杂请求、屏幕上下文以及跨信息源操作;这不是今天首次宣布模型。
为什么重要:竞争开始取决于操作系统入口和任务交接,而不只是聊天质量。
影响谁:移动应用开发者应测试调用、权限和失败恢复,用户仍需检查发送消息等有副作用的操作。
来源:TechCrunch AI · With iOS 27, I’m actually using Siri again
发生了什么:Daydream借助Apple Intelligence,把保存的服装图片转为可购买结果,并支持通过Siri搜索商品而不必打开应用。
为什么重要:这是系统级助手向第三方商业流程分发的具体案例,比单纯增加聊天框更接近交易闭环。
影响谁:电商团队应关注商品识别准确率、跳转归因和用户照片授权,不能把入口曝光直接等同成交增长。
发生了什么:9月13日报道显示,Music v2.5已提供应用和API入口,旧版v2仍可访问;官方称模型使用获许可音乐训练,商业使用受具体条款限制。
为什么重要:产品价值同时取决于音质、版本兼容与授权边界;近期签署的UMG协议不应误读为当前版本训练来源的证明。
影响谁:创作者及音频产品团队可做盲测,但上线前应核对归属、署名和禁止模仿现有艺人的限制。
发生了什么:AllSpark推出基于Qwen的Iris-mini与Iris-pro,9月13日报道称同时提供训练方案;同尺寸开放模型中的领先表现属于论文报告结论。
为什么重要:可复现的数据与训练流程,比单一分数更有助于构建专用检索代理。
影响谁:研究和企业搜索团队应测试陌生知识、多跳检索与引用可靠性,避免把已有知识的联网确认当作真正发现。
来源:The Decoder · Iris-mini and Iris-pro are the strongest open-weight search agents in their class
发生了什么:9月13日的评测报道比较了GPT-6 Astra在Vending-Bench与无人机控制任务中的表现,并称其在相关任务上超过对照基线;这是评测进展,不是今日模型发布。
为什么重要:长链执行和约束遵守正在成为能力评价重点,但模拟结果不能直接证明生产可靠性。
影响谁:智能体运营者应复现自己的任务分布;涉及物理设备时必须保留隔离测试、人工接管与权限限制。
来源:The Decoder · GPT-6 Astra pilots a surveillance drone and runs a business on its own
发生了什么:微软为MAI模型发布行为准则,要求支持人类控制,并设置不得入侵系统或欺骗人类等具体安全约束。
为什么重要:当模型获得工具访问权时,行为规则将影响实际任务授权和事故责任,不能只视为品牌宣言。
影响谁:企业采购与安全团队应把这些原则转为可测的拒绝行为、审计记录及越权测试,而非默认所有微软产品已同步实现。
发生了什么:TechCrunch援引报道称,OpenAI收购智能手机相机技术公司Glass Imaging,交易金额约3亿美元;该公司由前苹果工程师创办。
为什么重要:若交易细节获确认,视觉采集与成像技术会补强AI硬件能力,但尚不能据此推断设备上市时间。
影响谁:硬件供应链及多模态开发者应关注后续产品整合,避免把收购消息当作终端已经交付。
来源:TechCrunch AI · OpenAI buys smartphone camera maker Glass Imaging for $300 million, report says
发生了什么:Superhuman收购YC支持的Fathom;报道指其月活用户超过40万,累计有超过100万人用其记录会议。
为什么重要:邮件、会议和后续行动的数据正在向统一生产力平台集中,独立记录工具面临分发和整合压力。
影响谁:企业用户应审查录音同意、保存策略、数据迁移及后续价格变化,厂商则需要证明记录能转换为可追踪行动。
发生了什么:The Decoder援引404 Media称,OpenAI有数百名合同工作人员阅读并评分真实ChatGPT对话;提示虽经匿名化,仍可能含敏感信息。
为什么重要:匿名化不等于不可识别,质量改进链条也属于企业的数据出境与第三方访问风险。
影响谁:组织管理员应核对实际套餐和数据控制条款,不应把消费者服务报道直接套用于所有企业API;员工需避免输入敏感原文。
来源:The Decoder · OpenAI has hundreds of contract workers reading your ChatGPT conversations
发生了什么:报道称Anthropic向投资者预计连续第二季度盈利,并考虑纳斯达克上市,但所用调整后指标排除了股权薪酬等费用。
为什么重要:收入增长不等于标准会计口径下盈利,资本市场叙事需要拆解算力支出和调整项目。
影响谁:投资者及长期采购方应关注现金流、成本承诺和上市文件;目前不应写成IPO已完成或盈利已审计确认。
发生了什么:路透9月14日的报道标题显示,DeepSeek聘任具有交易经验的财务负责人,背景是可能进行IPO;本条依据新闻聚合收录,未取得全文。
为什么重要:财务组织建设是商业化与资本治理信号,不代表上市时间、地点及估值已敲定。
影响谁:企业客户可继续观察合同、服务保障及合规组织的成熟度,投资者需等待正式披露而不是把准备动作当作发行承诺。
发生了什么:Pandaily报道DeepSeek应用灰度测试原生AI语音聊天,并列出四种TTS声音;TechNode也出现同主题报道。当前仅按有限测试处理。
为什么重要:语音会降低移动端使用门槛,但灰度范围不代表所有账户、地区或API已经开放。
影响谁:应用用户需以账户实际入口为准,开发者应关注时延、中断处理和音频数据政策;本条不推断底层新模型发布。
发生了什么:TechNode报道Z.ai完成约50亿美元融资,用于下一代GLM模型;本条依据聚合条目,交易结构与资金到账细节尚未独立核验。
为什么重要:资金投入可支持后续训练,但融资规模不能替代模型质量、成本及服务稳定性的证据。
影响谁:模型采购方应继续用实际任务与SLA选型,投资者需核验原始融资公告和交易条件,不将本条当作新GLM产品已上线。
发生了什么:9月14日报道称Altman继续支持放缓发展节奏,OpenAI在重大训练前执行安全检查,并据媒体消息与Anthropic和Google讨论共同自律。
为什么重要:训练前门槛可能影响模型交付周期,但自律讨论尚不是跨公司可执行的统一监管制度。
影响谁:依赖前沿升级的团队需准备多供应商和版本锁定方案,不应把高管表态直接换算为确定延期日期。
发生了什么:黄仁勋与特朗普通话时表示不会让AI放缓发生;这与部分模型公司领导人的减速倡议形成明确分歧。
为什么重要:算力供应商与模型开发方的风险判断及商业激励并不相同,行业不存在一致的暂停路线。
影响谁:基础设施采购者应按已签订单和利用率做预算,不能把政治表态理解为出口许可或供货规则已经变化。
发生了什么:The Decoder报道,中国外交部批评美国AI领导人的风险言论,认为其可能被用于固化美国优势;相关报道同时涉及国内安全治理立场。
为什么重要:安全讨论已经与国际竞争交织,各市场的治理路径可能继续分化。
影响谁:跨境部署团队应分别跟踪当地法规、评测及数据要求,不应把外交措辞当作无需安全约束的政策豁免。
发生了什么:Wired报道,曼哈顿地区检察官办公室查封12个有害深度伪造网站,合计涉及约1200名受害者。
为什么重要:治理正从原则争论转向网站和基础设施层面的实际执法,滥用成本开始具体化。
影响谁:图像平台、托管商与支付服务需完善投诉、移除及证据保全流程;生成能力不能脱离同意与人格权讨论。
来源:Wired AI · New York Seizes a Dozen Celebrity Deepfake Websites
发生了什么:Wired对160个深度伪造网站的分析发现,22国政界人士出现在相关内容中,受害者几乎都是女性。
为什么重要:这不是普通的内容质量问题,而是定向骚扰与公共参与风险,也凸显仅依赖用户举报的不足。
影响谁:平台治理团队应优化身份保护、快速申诉和重复上传检测,公共机构需要预设跨平台处置机制。
来源:Wired AI · Sexually Explicit Deepfake Sites Target 100-Plus Politicians in Europe
发生了什么:9月13日报道介绍一名法学教授连续两年比较禁用AI、无指导使用和结构化培训的结果,禁用组两年都表现最差。
为什么重要:证据支持把使用能力和核验训练纳入课程,但特定课堂研究不能证明所有学科都适用同一政策。
影响谁:学校和企业培训部门可试行有监督的任务设计,分别测量学习、独立能力及对错误输出的识别,而非只统计工具使用率。
发生了什么:Wired近期分析指出,产业从单次聊天请求转向资源密集型智能体,成为数据中心扩建的重要驱动;本条为趋势背景,不是新电力合同公告。
为什么重要:单次调用价格下降不保证端到端任务成本下降,重复搜索、重试与长上下文可能抵消节省。
影响谁:运营团队应记录每个成功任务的总调用量、耗时和成本,并限制无收益循环,再决定是否扩大自动化范围。
影响评估
来源说明与公司雷达
首选Perplexity两次查询均无结果,转用RSS,获得571条去重候选,并抽查产品原文。主体覆盖北京时间9月13日至15日,部分为前两日产品与评测延续,并非全部今天首发。原文可读性有限的项目明确标注聚合依据;报道金额、性能与融资说法不等于独立审计。全文影响判断为编辑分析。
已扫描OpenAI、Anthropic、Google/Gemini、xAI/Grok、Meta/Llama、NVIDIA、Qwen、Kimi、DeepSeek、智谱GLM、MiniMax、MiMo、文心、混元、豆包以及Codex、Claude Code、Gemini CLI、Qwen Code。未取得可靠新产品证据的公司不凑数;Kimi检索大量命中赛车同名人物,已剔除。关于Kimi K2.8、Grok版本路线及Gemini泄露等零散条目未列为已确认发布。本期20条包含产品、评测、商业进展、治理及明确标注的趋势背景。