从旗舰模型降价到端侧代理,今天优先看能改变开发和采购决策的产品变化。
核心判断:竞争正在从“谁的模型最强”转向“完成一个可靠任务需要多少钱”。低 token 单价只是开始,重试、最高推理档和数据治理都可能改变最终账单。
今日信息图
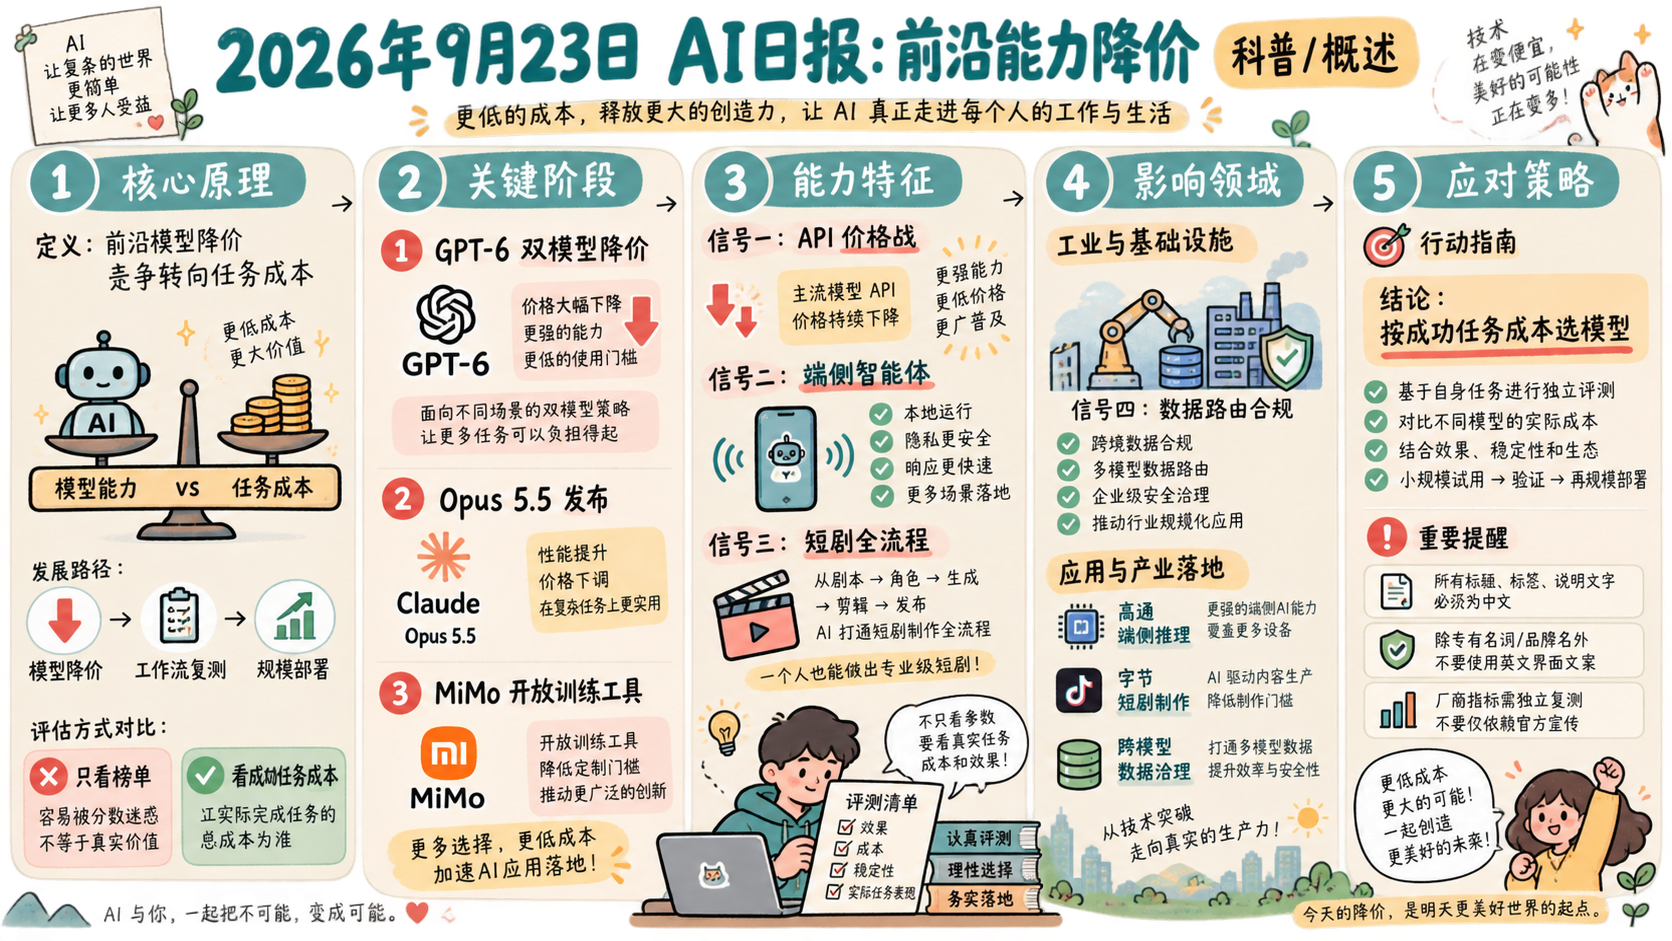
按成功任务成本选模型:单价、推理档位、缓存和可靠性一起评估。
今日摘要
Opus 5.5 与 GPT-6 Sol、Luna 在9月22日同日发布,分别从旗舰能力与分层价格推动模型重新选型。小米 MiMo 的开放训练环境说明,竞争不仅在权重,还包括奖励、任务与验证器。对构建者而言,最有价值的行动是拿真实工作负载重新测成本、时延和成功率,而不是凭榜单直接替换线上模型。
另一条主线是代理进入更多执行环境:高通推动端侧语音代理,字节把短剧制作变成协作流水线,消费级个人代理强调跨平台。与此同时,数据路由调查报道提醒采购方:你购买的模型品牌不必然等于唯一数据处理方。事实、厂商主张与编辑判断必须分开。
关键判断
Top 20 新闻
01 · Opus 5.5:旗舰能力下放,别把单价降幅当总成本降幅
发生了什么:9月22日官方发布 Opus 5.5,每百万输入/输出 token 为4/20美元,缓存读取0.20美元。厂商称典型默认工作负载成本较 Opus 5 降低约40%,但 token 单价降幅为20%。
为什么重要/影响谁:编程代理、法律和金融知识工作可重新评估模型路由。独立评测提示最高推理档可能消耗更多 token,采购应比较成功任务成本,而不是只看“更便宜”的宣传。
来源:Claude Opus 5.5 matches Fable 5.1 performance at lower cost and promises less "Claudish" writing
02 · GPT-6 Sol 与 Luna 发布,API价格较上一代减半
发生了什么:9月22日发布的 Sol 面向复杂编程等任务,Luna 面向摘要、信息抽取等高吞吐任务;TechCrunch 确认进入 ChatGPT Work、Codex 和 API,并分批覆盖其他入口。官方称事实错误和编码错误减少。
为什么重要/影响谁:这是开发者今天最直接的迁移窗口:复杂任务与批处理可以分层采购。官方“减半”的比较基准是 GPT-5.6 同系列促销价,不能据此推导所有任务账单都减半;先复测工具调用与回归用例。首发入口是 Work、Codex 和 API,普通 Chat 尚未开放。
来源:OpenAI launches GPT-6 Sol and Luna, boasting lower cost and fewer mistakes
03 · MiMo-V2.6-Pro:低价开放模型与强化学习工具一起竞争
发生了什么:9月22日报道显示 MiMo-V2.6-Pro 在 Artificial Analysis 指数取得46分;报道价格为每百万输入0.435美元、输出0.87美元。小米同时开放训练框架和约7000个带自动评分器的任务。原始首发日期本次未独立确认,按最新评测与生态进展收录。
为什么重要/影响谁:对自部署团队和后训练研究者,价值不只在模型权重,也在可复用的训练环境。性能与成本需在自有任务上验证;关于训练数据来源的争议属于厂商指控,不作已证实结论。
04 · 阿里展示真武 V900,超大 Qwen 模型仍是路线图
发生了什么:9月22日多家媒体报道阿里展示新一代 AI 芯片并公布更大规模 Qwen 模型规划;报道涉及最高十万亿参数目标。这里是芯片展示与训练路线图,不是已上线模型公告。
为什么重要/影响谁:云端算力、模型和智能体的一体化布局影响企业采购及国产算力适配。参数数量不能替代可用性、实测吞吐或软件兼容性,开发者不应提前按未发布模型做迁移承诺。
05 · 腾讯推出新图像模型,生成式视觉竞争继续加码
发生了什么:9月22日 Bloomberg 经 Yahoo 分发的报道指出腾讯发布新 AI 图像模型,瞄准字节和阿里的竞争产品。本次可核实信息以新闻标题与摘要为限,不扩写未确认的版本、价格或榜单。
为什么重要/影响谁:对电商设计、广告与内容制作团队,新增供应商值得加入同提示词盲测。上线决策应看中文文字、角色一致性、可编辑性和版权条款,而非股价反应。
来源:Tencent Releases AI Image Model to Catch ByteDance, Alibaba - Yahoo Finance Australia
06 · 骁龙双旗舰芯片,把语音代理和大模型推向手机本地
发生了什么:高通发布 Snapdragon 8 Elite Gen 6 与 Extreme Gen 6;报道确认高配可本地运行总参数量300亿的 MoE 模型,新感知中枢支持小模型和语音交互。总参数不等于每次推理激活参数。
为什么重要/影响谁:手机厂商和端侧应用开发者可探索低延迟、离线及隐私优先的代理。但芯片能力不代表所有量产手机已交付相同功能,仍要验证内存占用、功耗和持续推理表现。
来源:Qualcomm launches two new smartphone chips with emphasis on AI
07 · Grok 4.7:低价切入,但代理编程仍有差距
发生了什么:9月21日发布进展作为48小时补充:Grok 4.7 报道定价为每百万输入2美元、输出6美元,可经 API、Cursor 与 Grok Build 使用。The Decoder 引用独立指数46分,并指出终端编程测试仍落后于领先模型。
为什么重要/影响谁:适合把它作为候选路由而非全面替代旗舰。编码团队应测长任务恢复、工具正确率与修改回归;单项总分不能证明生产环境的复杂代理能力。
来源:xAI launches Grok 4.7 at bargain prices, but benchmarks reveal a wide gap to Claude and GPT-6
08 · Dramagic 把短剧制作串成完整流程
发生了什么:9月21日报道的 Dramagic 通过 BytePlus 提供企业接入,覆盖剧本分析、角色创建、分镜和视频预览,支持多人协作与一致性检查;按近48小时产品动态收录。
为什么重要/影响谁:短剧平台的竞争从单次生视频转向资产、版本与协作。制作团队应优先评估角色资产复用、镜头可控性和返工成本,而不是只比较首条视频的观感。
09 · Meta承认 Muse 深受 OpenClaw 启发,但称从头构建
发生了什么:9月22日 Meta 产品负责人回应 Muse 工作区文件与 OpenClaw 相似,承认产品设计受到强烈启发,同时强调并非直接套壳。报道中的相似文件不能自行证明底层代码来源。
为什么重要/影响谁:个人代理的可读配置和持久工作区正从开发者工具扩散到大众产品。开源团队需思考可迁移性与差异化,企业用户则应关注权限隔离和数据出口,而非只看交互相似度。
来源:Meta admits Muse’s likeness to OpenClaw isn’t a coincidence
10 · Rabbit转向 OS3 跨平台代理应用
发生了什么:WIRED 9月22日报道 Rabbit 推出 OS3,以跨平台应用形态承接个人代理,而不再只依赖专用硬件。此条依据该媒体 RSS 摘要,正文抓取不完整,因此不列未核实的收费与平台清单。
为什么重要/影响谁:消费级代理获客可能回到用户已有设备。应用团队应考察系统权限、后台执行稳定性和任务恢复,避免把演示中的自动操作等同于可靠的长期托管。
11 · Kimi K3进入亚马逊云分发渠道
发生了什么:Silicon UK 9月22日报道亚马逊云平台加入 Moonshot 的 Kimi K3。本条的新信息是云平台分发,而不是把既有 K3 模型重写为今天首次发布;具体区域与合同以云控制台为准。
为什么重要/影响谁:企业采用中国模型的门槛可能因统一采购和云治理而降低。但模型权重来源、推理地域和日志保留是不同问题,合规团队仍需逐项核对。
来源:Amazon Adds Moonshot’s Kimi K3 To Cloud Platform - Silicon UK
12 · DeepSeek训练转向更多国产芯片,迁移难度不能忽略
发生了什么:9月22日 DIGITIMES 等报道 DeepSeek 计划更多使用华为及国产芯片进行训练。这里描述的是供应链策略与报道中的计划,不代表所有训练已迁移完成。
为什么重要/影响谁:算力供应商和基础设施团队需关注通信库、算子覆盖、故障恢复与训练效率。硬件替代能降低单一供应依赖,但只有长期集群运行数据才能证明真实经济性。
来源:DeepSeek bets on Huawei chips for model training as Nvidia's China sales slip - digitimes
13 · 数据路由调查报道:采购审计必须穿透“模型品牌”
发生了什么:Bloomberg 等9月22日报道中国监管机构调查 DeepSeek、Moonshot 相关数据安全问题,报道与 Anthropic 关于请求流向 Claude 的指控有关。尚不能据媒体报道认定泄密、违法或调查结论。
为什么重要/影响谁:受影响者包括企业客户、代理平台和模型聚合商。实务重点是明确实际处理方、子处理商、跨境流向及日志策略;切勿把指控升级为已证实事实。
来源:China Probes DeepSeek, Moonshot Over Data Security, Report Says - Bloomberg.com
14 · Snorkel融资3.5亿美元,数据与训练环境仍是稀缺资产
发生了什么:9月22日 Snorkel 宣布 E 轮融资3.5亿美元、估值35亿美元;公司转向提供完整数据集和强化学习环境。其年化收入运行率由公司披露,不等于已审计全年收入。
为什么重要/影响谁:模型实验室与企业后训练团队的预算正流向高质量反馈和可验证环境。投资者应区分数据服务与人工专家市场的收入确认口径,不能把不同公司的年化收入数字直接横比。
来源:Snorkel AI triples valuation to $3.5B as demand for AI training data booms
15 · “神经元衍生”视频模型合作仍处早期预约阶段
发生了什么:TBC宣布与 AWS 合作,计划在 Trainium、SageMaker AI 和 Marketplace 上提供视频模型。所谓神经元衍生是把实验观测转化为软件适配层,不是让客户用活体脑细胞推理。
为什么重要/影响谁:厂商声称提速五倍、推理成本降低80%,但目前仅早期接入登记,基础模型也未披露。视频团队应等可复现实测,暂不把宣传收益写入成本预算。
来源:A tiny software layer from lab-grown neurons promises faster, cheaper AI video
16 · AstroForge计划让小型AI模型参与航天器控制
发生了什么:9月22日报道称 Autonomy-1 将使用小型 Transformer 模型参与航天器运行,设想包括异常诊断与处理。这是计划中的自主系统实践,而非已完成的无人深空任务成绩。
为什么重要/影响谁:航天和工业控制团队面临相同问题:模型如何在通信受限时安全行动。可验证边界、故障回退和人工接管设计比对话能力更关键。
来源:AstroForge is putting AI in command of its next spacecraft
17 · 安全研究开始识别依赖AI聊天模型的恶意工具
发生了什么:WIRED 9月22日报道 Cisco Talos 创建识别 AI 集成恶意软件与黑客工具的框架,并发现自动化指挥系统线索。正文读取有限,本条不推断其攻击规模或“全面无人化”程度。
为什么重要/影响谁:安全运营团队应把模型 API 调用、异常凭据使用和代理工具链纳入检测范围。风险不只来自更好的钓鱼文案,也来自攻击流程的自动编排;仍需逐案证据。
来源:A New Tool Found Malware That’s Guided by an AI Hive Mind—No Humans in Sight
18 · OpenAI倡议递归自我改进的国际标准
发生了什么:9月22日报道 OpenAI 推动共同测量方法、事故报告与自动化 AI 研究中的人工监督。公司明确指出,完全自主的递归自我改进并未在今天发生。
为什么重要/影响谁:前沿实验室及研究代理开发者应预备可审计研究链条。把治理倡议误读为技术能力已经实现,会同时误导风险评估和投资判断。
来源:OpenAI calls for international standards on AI that could improve itself
19 · 据路透报道,DeepSeek将参与安理会AI风险简报
发生了什么:9月22日路透消息称 DeepSeek 将在本周向联合国安理会介绍 AI 风险,相关报道也涉及 OpenAI、Anthropic。此为会议安排报道,不是已形成国际协议或新监管法。
为什么重要/影响谁:AI风险议题进入国际安全讨论,跨境部署企业需持续跟踪出口管制和安全标准。短期应收集正式会议文件,不宜据此预判立刻发生全球统一监管。
来源:DeepSeek to brief UN Security Council on AI this week, sources say - TradingView
20 · Nscale IPO将检验市场如何定价客户集中风险
发生了什么:TechCrunch 9月22日指出英国 AI 数据中心开发商 Nscale 的 IPO 面临收入高度依赖 Microsoft 与 Anthropic 的结构性问题。此条关注业务风险,不据此编造发行价格或上市完成状态。
为什么重要/影响谁:算力投资者和采购方应核对客户合同期限、电力交付及融资匹配,而非只追踪总订单。模型降价并不自动抹平数据中心长期资本开支与客户集中度风险。
来源:Nscale’s IPO will test Wall Street’s appetite for concentrated AI bets once again
影响评估
来源与公司雷达
先尝试 Perplexity web_search,返回空结果后采用公开 RSS 与正文提取交叉核验。基础候选614条,另做公司与编码工具定向扫描;候选数量不等于独立事件数。OpenAI 与 Anthropic 首发日期已核对文章或官方页面。MiMo首发日期未独立确认,按9月22日评测报道收录;Grok、Dramagic明确标为48小时补充。不将更早的 Anthropic 生物实验室报道伪装为今日发布。
固定雷达覆盖 OpenAI/ChatGPT/Codex/Sora、Anthropic/Claude Code、Google/Gemini/Gemini CLI、xAI、Meta、NVIDIA、Qwen/Qwen Code、Kimi、DeepSeek、GLM、MiniMax、MiMo、百度文心、腾讯混元和字节豆包。Googlebook和智谱编码安全相关线索证据不足,本期不扩写;MiniMax与百度未确认足够强的独立产品更新,不为凑公司名单占据榜单。扫描不等于断言这些公司没有任何新闻。
部分条目仅依据可信媒体的RSS标题与摘要,已在条目中说明抓取限制。厂商性能、速度和成本承诺不视为本报告独立实测;媒体调查与指控均保留归属。正文中的采购建议属于编辑分析。